LLM recommender: fine-tuning eleva explicação segura a 95,6%

LLM recommender: fine-tuning eleva explicação segura a 95,6%

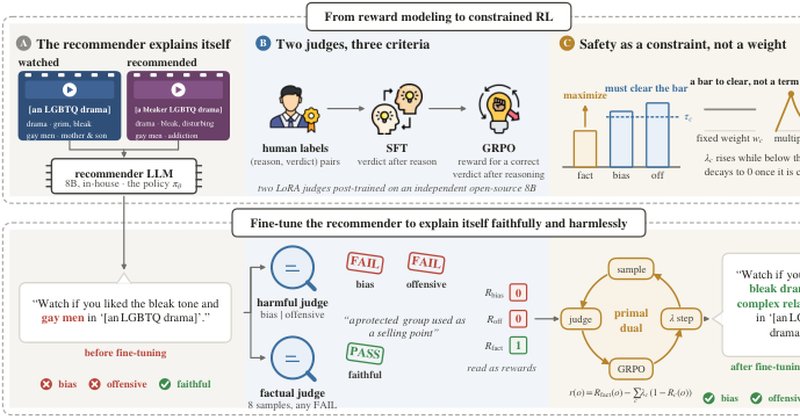
Um LLM recomendador ajustado com constrained GRPO passou a explicar suas próprias indicações com fidelidade e sem conteúdo prejudicial, segundo o artigo arXiv:2609.13657v1. A taxa de aprovação nos três critérios avaliados subiu de 64,9% para 95,6% nas avaliações internas e de 67,7% para 93,1% com um juiz independente.
Por Redação Mapa Paper15 set
CoMA-DiT: Diffusion Transformer decodifica estados cerebrais

CoMA-DiT: Diffusion Transformer decodifica estados cerebrais

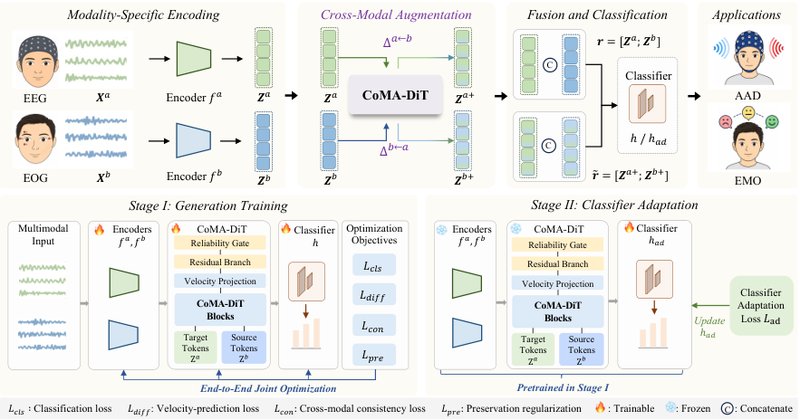
O CoMA-DiT, Diffusion Transformer bidirecional de aumento cross-modal, superou 20 baselines em decodificação de estados cerebrais multimodais, com ganhos de 4,28% em acurácia e 6,70% em macro-F1. O método trata modalidades pareadas como fontes de supervisão generativa mútua, não apenas como entradas para fusão.

Por Redação Mapa Paper12 set
Mr.LHDR: benchmark testa agentes de deep research de longo prazo

Mr.LHDR: benchmark testa agentes de deep research de longo prazo

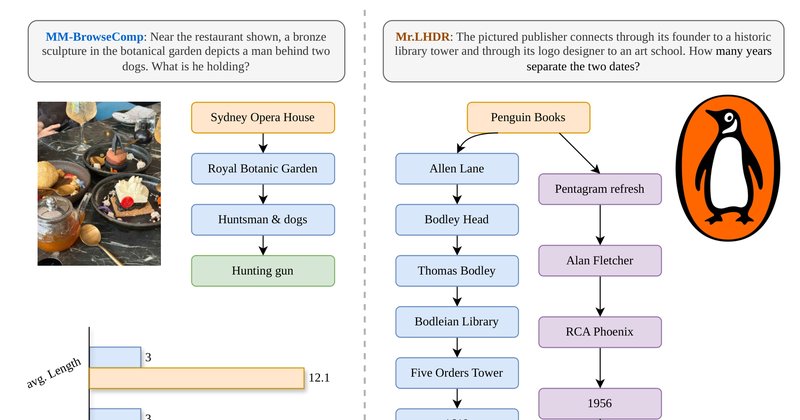
O Mr.LHDR, benchmark publicado no arXiv em 10 de setembro de 2026, exige em média 12,1 conclusões intermediárias por pergunta e mostra que o melhor sistema avaliado chega a apenas 43,1% de acurácia geral e 34,3% de acurácia estrita. Remover as imagens derruba o DACS em 12,6 pontos.

Por Redação Mapa Paper12 set
Alinhamento de estilo em coreano altera respostas de IA de 27B

Alinhamento de estilo em coreano altera respostas de IA de 27B

Pesquisadores post-treinaram o Qwen3.8-27B para estilo de resposta em coreano e viram abstenção e divulgação não solicitada se moverem, mesmo sem estarem no objetivo de treino. As estimativas de taxa de resposta variam de +0,82 a -1,53 ponto percentual entre sementes de estilo e neutras.

Por Redação Mapa Paper12 set
IA gera empresas fictícias consistentes em 66 sistemas

IA gera empresas fictícias consistentes em 66 sistemas

O artigo arXiv:2609.11286v1 descreve um gerador que cria empresas fictícias completas, com clientes, vendas e chamadas coerentes, sem usar nenhuma base real. O realismo médio subiu de 60,3 para 99,1 em 23 companhias geradas.

Por Redação Mapa Paper12 set
Benchmark mede valor do texto em previsão de séries temporais

Benchmark mede valor do texto em previsão de séries temporais

O paper arXiv:2609.11282 cria o primeiro benchmark com verdade fundamental para medir se anotações de texto realmente ajudam modelos de previsão de séries temporais. Seis estimadores de informação mútua foram testados e todos apontaram anotações corretas como as mais informativas, com validação em sete datasets reais.

Por Redação Mapa Paper12 set
NovGauge: benchmark expõe falhas de LLMs ao julgar novidade de papers

NovGauge: benchmark expõe falhas de LLMs ao julgar novidade de papers

O NovGauge, novo benchmark publicado no arXiv, avalia como 18 LLMs julgam a novidade de papers científicos em três dimensões. As taxas de alucinação chegam a 39% e mais de 70% das justificativas corretas citam evidências que não sustentam o argumento.

Por Redação Mapa Paper12 set
SemVerBench mede se LLMs entendem regras de versão

SemVerBench mede se LLMs entendem regras de versão

O SemVerBench é o primeiro benchmark a medir se LLMs entendem regras de versão em npm, PEP 440 e Cargo. Nos casos de borda do PEP 440, o GPT-5.1 acertou 0 de 26 itens, enquanto o Claude ficou entre 97% e 100%.

Por Redação Mapa Paper12 set
Estudo: oligopólio da IA não acelera colapso de modelos

Estudo: oligopólio da IA não acelera colapso de modelos

Estudo na arXiv testa ecossistemas de 3 a 13 modelos abertos por cinco gerações e conclui que a concentração de mercado não altera o destino nem a velocidade do colapso. O que define o ritmo é quem fornece o texto do pool e a suscetibilidade de cada fornecedor.

Por Redação Mapa Paper12 set
Benchmark Radar: banco vivo mapeia benchmarks de IA

Benchmark Radar: banco vivo mapeia benchmarks de IA

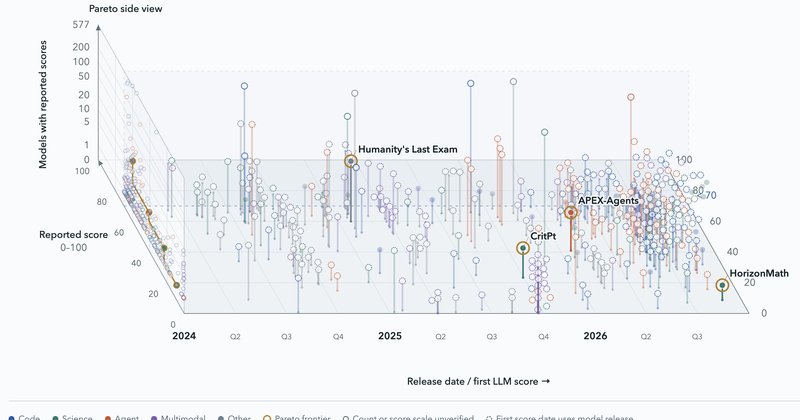
O Benchmark Radar, banco de dados vivo e motor de busca de benchmarks de IA, foi apresentado no arXiv e reúne 1.283 registros de fontes e 12.916 observações numéricas. O sistema faz coleta diária a partir de 37 fontes e lança dashboard com leaderboard, fronteira de Pareto e visões de saturação.

Por Redação Mapa Paper12 set