
Modelo ERDM simula como agentes desenvolvem comportamentos adaptativos e maladaptativos
Estudo no arXiv:2608.23932v1 apresenta o ERDM, um modelo de aprendizado por reforço que reproduz comportamentos humanos sem programação explícita.
Estudo no arXiv:2608.23932v1 apresenta o ERDM, um modelo de aprendizado por reforço que reproduz comportamentos humanos sem programação explícita.
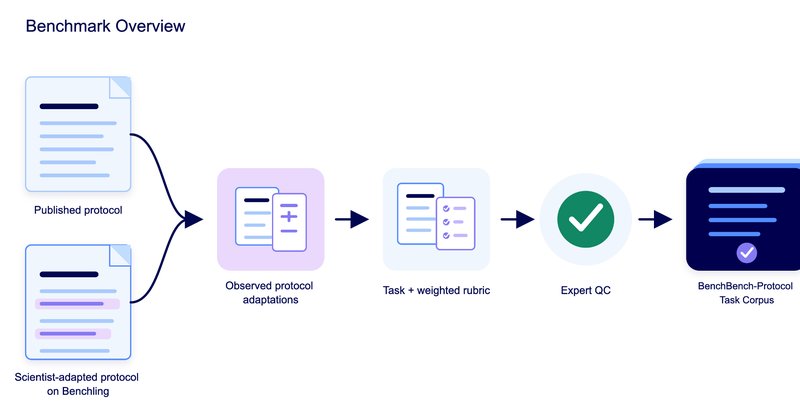
Benchmark BenchBench-Protocol avalia nove modelos de linguagem em 149 tarefas reais de modificação de protocolos de laboratório. Claude Opus 5 lidera com 59,2% de acerto.
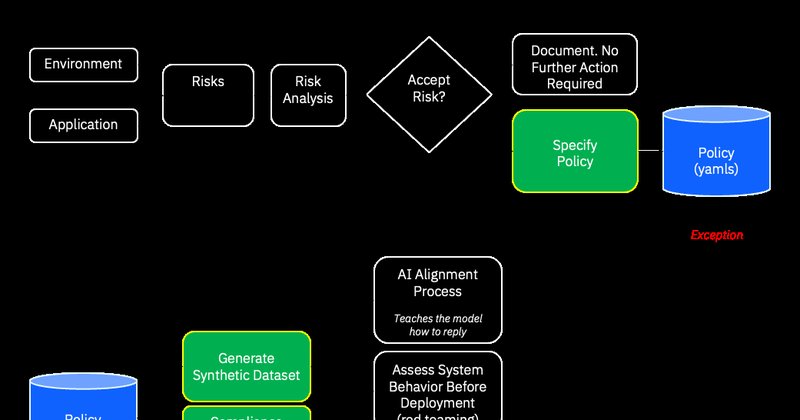
A IBM lançou o Granite.Trust Policy Tools, um conjunto de ferramentas open source para definir e aplicar políticas de segurança em aplicações de IA generativa, incluindo um schema YAML e pipeline de dados sintéticos.
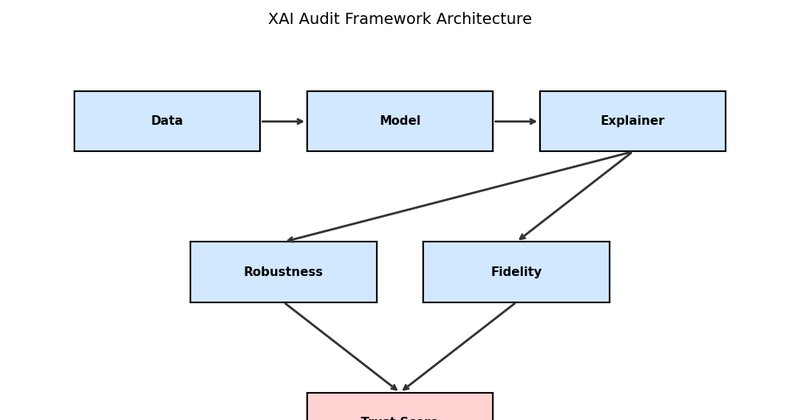
Estudo publicado no arXiv propõe framework para auditar robustez e fidelidade de explicadores de IA como SHAP e LIME, revelando que modelos com AUC acima de 0,99 podem gerar explicações enganosas.
AgentRoom, protocolo baseado em CRDTs, permite que agentes de codificação trabalhem concorrentemente com coordenação em tempo real, reduzindo abandons de tarefas em testes com cinco modelos de CLI.
Pesquisadores propõem FLARE, um framework para avaliar a viabilidade econômica de IA na saúde, com break-even em 3.992 pacientes por ano.
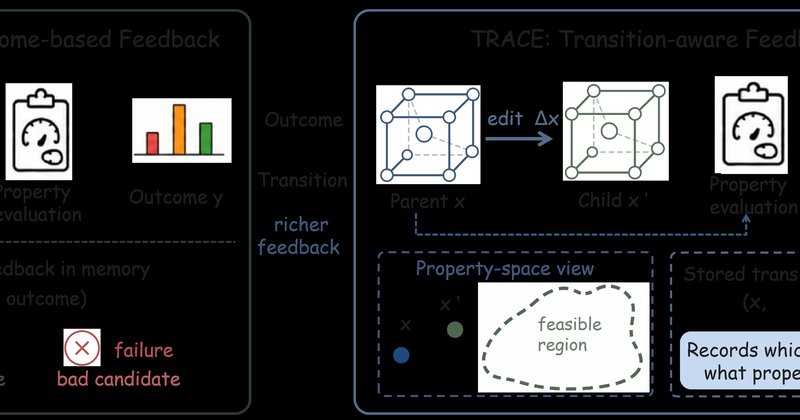
O framework TRACE, descrito em estudo no arXiv, trata cada edição avaliada como unidade de aprendizado e elevou a taxa de acerto de 18,13% para 25,96% em comparação controlada com o LLEMA na descoberta multi-objetivo de materiais.
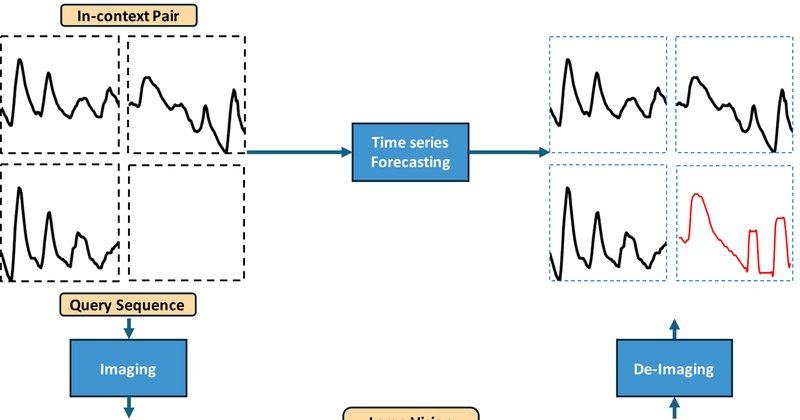
Pesquisadores publicaram no arXiv o framework ICI-Time, que usa grandes modelos de visão para prever séries temporais transformadas em gráficos de área, sem precisar de fine-tuning. Testado em epidemiologia, meteorologia e energia, o método se mostrou competitivo com deep learning e promete funcionar em cenários com poucos dados.
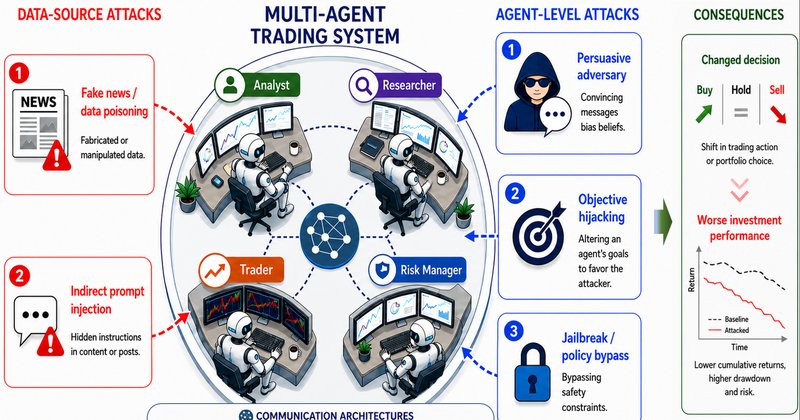
Estudo do arXiv revela que sistemas de trading multi-agente baseados em LLM são vulneráveis a ataques via dados e prompts, sem exigir acesso interno. Nenhuma arquitetura de comunicação se mostrou intrinsecamente segura.
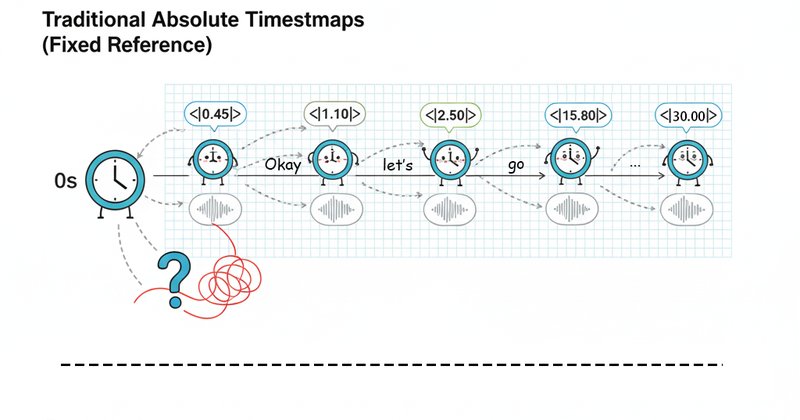
Paper submetido ao arXiv em 25 de agosto de 2026 propõe timestamps relativos e treino mascarado para SpeechLLMs preverem a posição temporal de cada palavra, melhorando a precisão sem sacrificar a transcrição.