
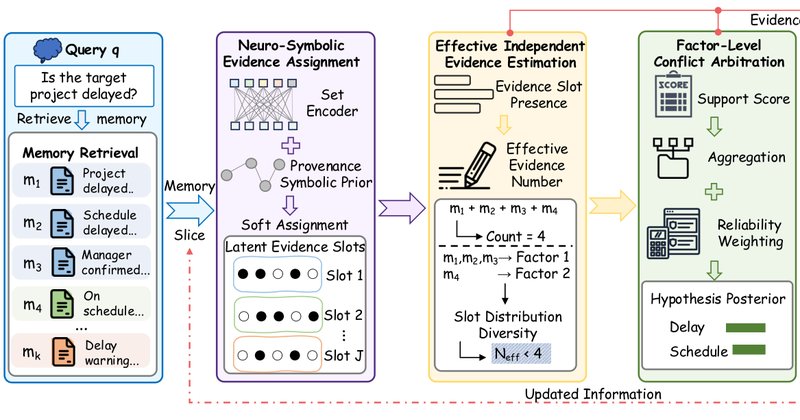
CAMA: framework combate viés em memórias de sistemas multi-agente
O framework CAMA aborda o problema de memórias correlacionadas em sistemas de IA multi-agente, promovendo evidências independentes para decisões mais precisas.
O framework CAMA aborda o problema de memórias correlacionadas em sistemas de IA multi-agente, promovendo evidências independentes para decisões mais precisas.
Pesquisa publicada no arXiv questiona avaliação por acurácia em simulações sociais com LLMs e propõe novo benchmark com 19.300 contextos para medir subjetividade de respostas humanas.
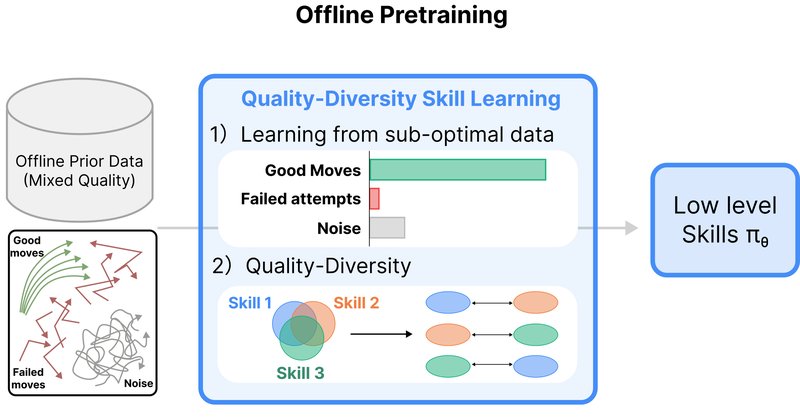
Pesquisadores propõem o QDOS, método que usa dados já coletados para treinar habilidades robóticas de forma mais inteligente e eficiente, superando abordagens anteriores.
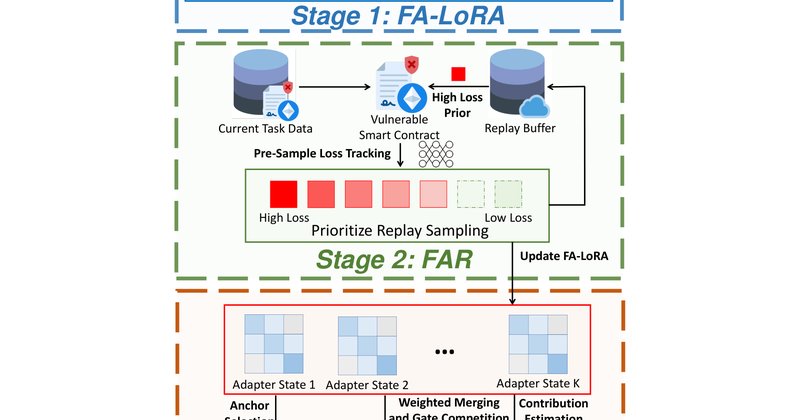
Pesquisa publicada no arXiv apresenta pipeline de três estágios que adapta LLMs para detectar vulnerabilidades em smart contracts com alta precisão e baixo custo computacional, resolvendo o esquecimento catastrófico entre atualizações.
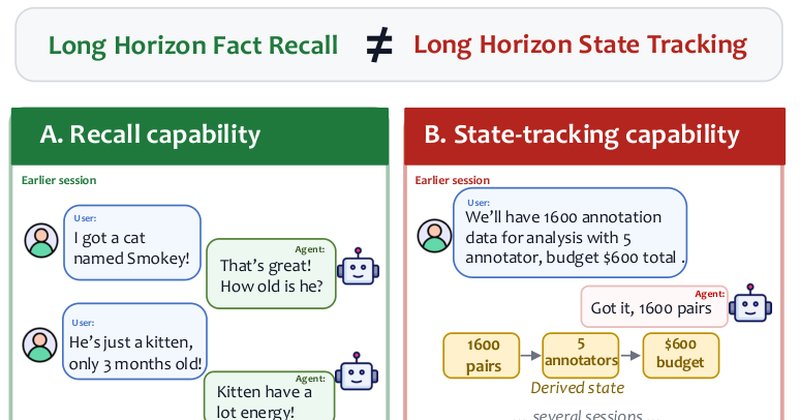
Pesquisa define 'rastreamento de estado' como habilidade crucial e apresenta método que dobra desempenho em sistemas de memória de IA, com testes em DeepSeek-V4-Flash e Qwen-3.5-9B.
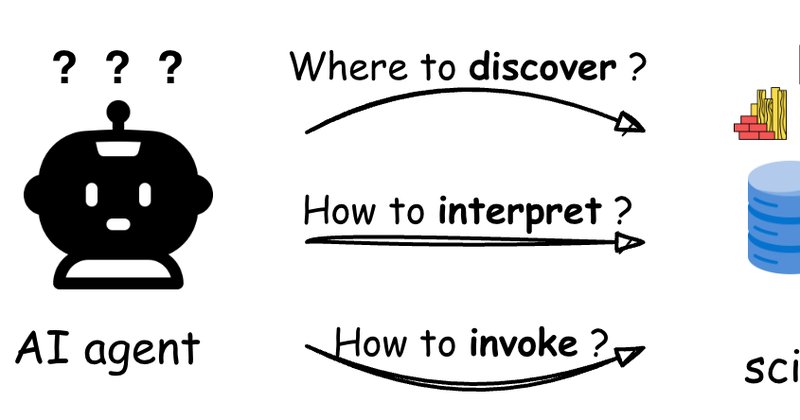
Novo paper do arXiv propõe o SciDSK, uma representação padronizada de dados científicos para facilitar o trabalho autônomo de agentes de IA, enfrentando a fragmentação e formatos inadequados para automação.
Novo estudo propõe método 'black-box' que usa dinâmica de sistemas para detectar respostas perigosas em LLMs, analisando a interação entre prompt e resposta em espaços de embeddings.
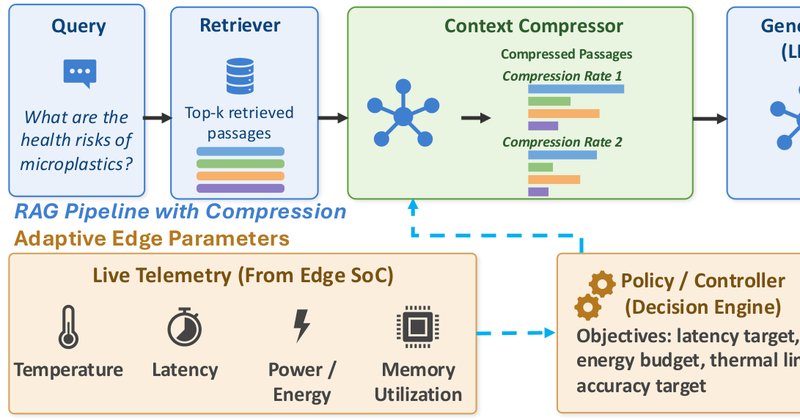
Estudo na arXiv demonstra que comprimir o contexto de IA de forma adaptativa em tempo real pode reduzir o consumo de energia de GPU em até 53% em dispositivos de borda, sem perda de qualidade.
Framework Symposium cria histórico imutável e auditável de agentes de IA em pesquisa científica, separando a memória durável da comunidade dos sistemas que evoluem rapidamente para garantir confiança nos resultados.
Pesquisa publicada no arXiv propõe o R2-OPD, método que filtra recompensas conflitantes durante destilação de modelos de linguagem para alinhar treinamento com progresso real de raciocínio.