
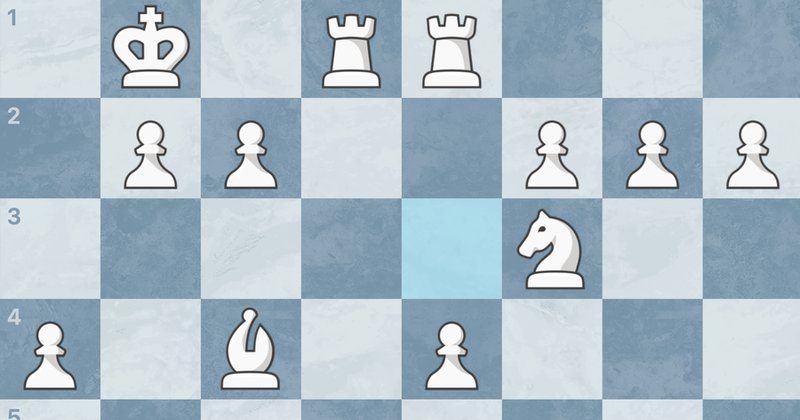
IA usa 1,5 bilhão de dados para criar puzzles de xadrez com valor pedagógico
Pesquisa publicada no arXiv usa 1,5 bilhão de históricos de resolução para treinar IA que identifica puzzles de xadrez com valor pedagógico real para iniciantes estagnados.
Pesquisa publicada no arXiv usa 1,5 bilhão de históricos de resolução para treinar IA que identifica puzzles de xadrez com valor pedagógico real para iniciantes estagnados.
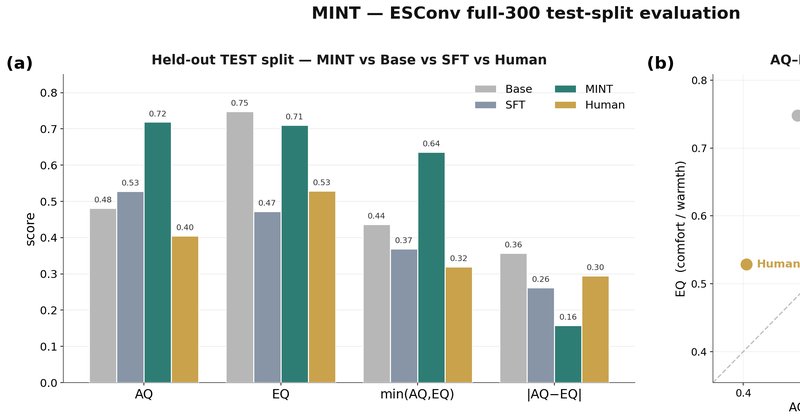
Novo método de treinamento de IA corrige desequilíbrio em modelos com múltiplos objetivos, elevando o desempenho do eixo mais fraco de 0.37 para 0.64 em testes de suporte emocional.
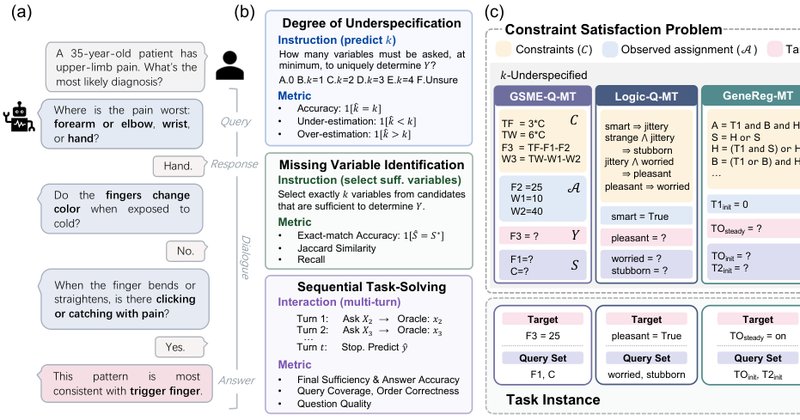
Estudo do arXiv revela que LLMs subestimam em 4x a informação necessária em perguntas vagas e falham ao planejar perguntas de acompanhamento, expondo uma lacuna crítica nas avaliações atuais.
Estudo do arXiv mostra que sistemas de IA limitados a dar conselhos podem, através de influência endógena, reduzir gradualmente a autonomia humana, levantando novas questões para a segurança de ferramentas assistentes.
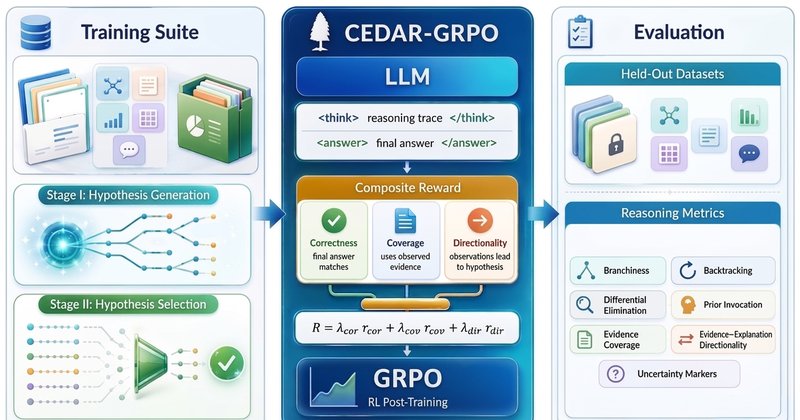
Novo framework de reinforcement learning melhora o raciocínio abdutivo em LLMs open-weight, com ganhos que se transferem para 11 tarefas distintas não vistas no treino.
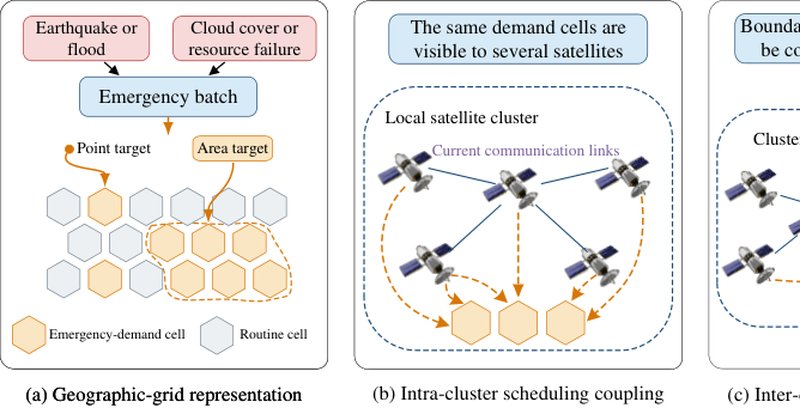
Pesquisa no arXiv propõe o método T3L-DS, que usa IA distribuída para inserir urgentes em planos de satélites, melhorando a cobertura e reduzindo perdas de rotina em até 87,7%.
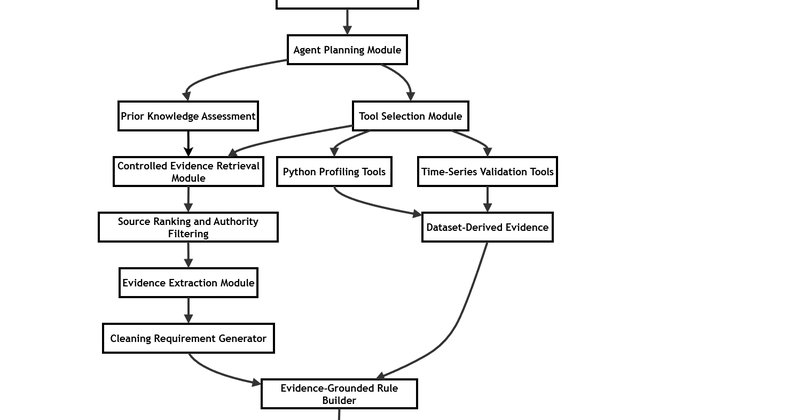
Estudo experimental com 126 testes mostra que agentes de IA para limpeza de dados sem referência enfrentam trade-offs entre capacidades, custo e precisão. Não há configuração vencedora universal.
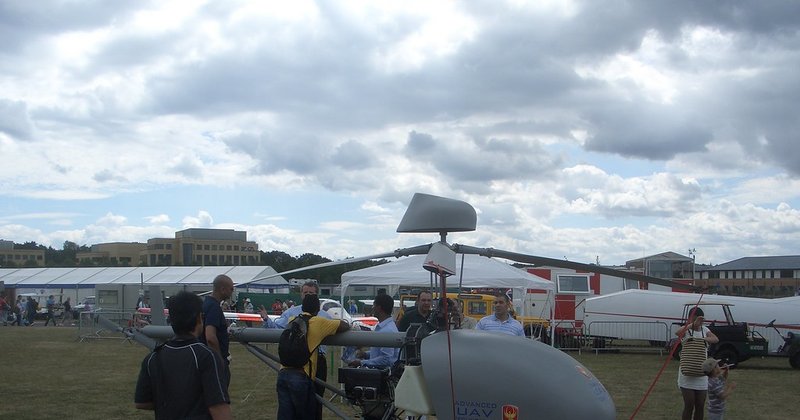
Pesquisa na arXiv aplica machine learning para transformar dados de segurança da aviação em insights preditivos, visando prevenir acidentes e incidentes.
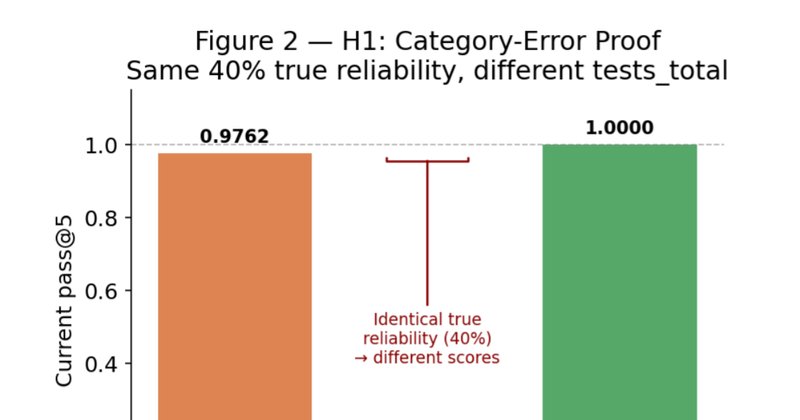
Estudo do arXiv prova que a métrica pass@k, padrão para avaliar agentes de código com IA, está sendo aplicada de forma incorreta, inflando resultados em até 97%. Autores propõem reliability@k e uma lente de segurança.
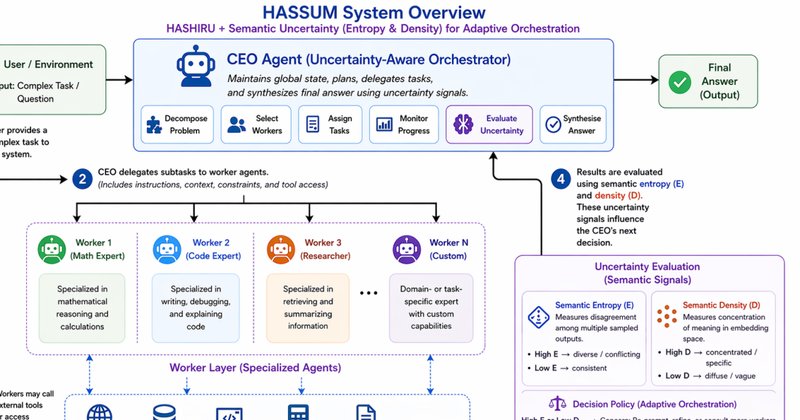
Um novo framework chamado HASSUM utiliza entropia e densidade semânticas para melhorar a coordenação em sistemas de IA multi-agente, reduzindo erros e alucinações em tarefas complexas.