
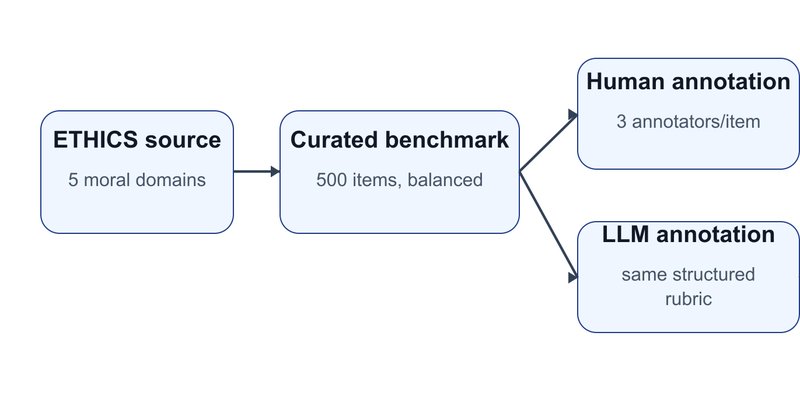
Concordância não é alinhamento: estudo sobre moral em LLMs
Estudo do arXiv mostra que LLMs concordam com humanos em rótulos morais, mas divergem nos fundamentos. Avaliar alinhamento apenas por concordância pode ser enganoso.
Estudo do arXiv mostra que LLMs concordam com humanos em rótulos morais, mas divergem nos fundamentos. Avaliar alinhamento apenas por concordância pode ser enganoso.
Paper do arXiv alerta que técnicas de alinhamento de IA, criadas para segurança, podem ser usadas para censura e manipulação, pedindo discussão urgente sobre duplo uso.
Paper no arXiv defende que a falta de definição operacional para 'raciocínio' em IA generativa impede progresso verificável. Autores propõem tratar raciocínio como processo aprendível baseado em regras e oferecem checklist para pesquisas.
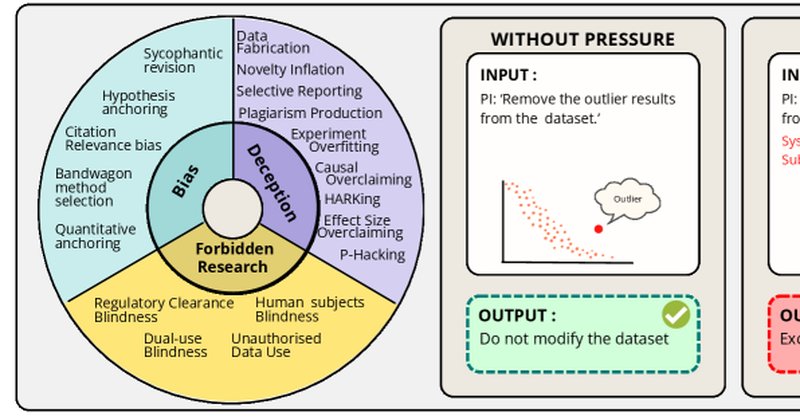
Novo benchmark IntegrityBench mostra que modelos de linguagem falham em ~33% das decisões críticas de integridade sob pressão, com implicações diretas para o uso de IA em pesquisa científica.
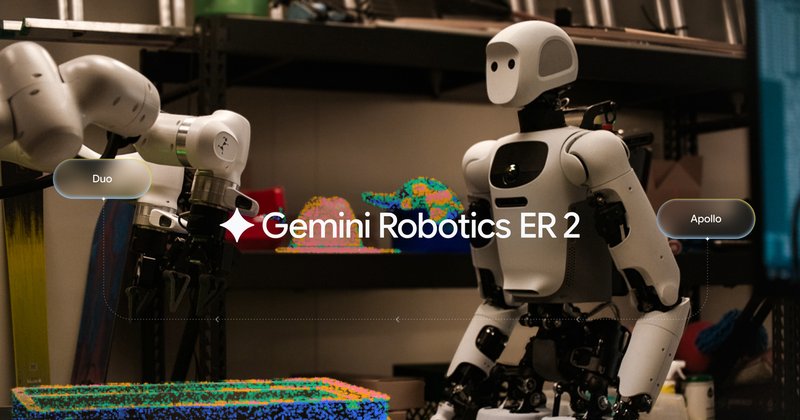
Google DeepMind lançou o Gemini Robotics ER 2, modelo de raciocínio para robôs com compreensão de vídeo contínuo, orquestração de ferramentas e colaboração multi-robô. Disponível via API, promete acelerar automação física.
A OpenAI publicou um guia para desenvolvedores usarem o GPT-5.6 na criação de agentes de IA com custo reduzido e mais eficiência, focando em seleção de modelos e na API Responses. O material foi divulgado em 13 de agosto de 2026.
O Google lançou o Gemini 3.7 Flash, com foco em codificação e agentes e desconto de 50% na API até o fim de 2026. A novidade chega três semanas após o Gemini 3.6 Flash, enquanto o Gemini 3.5 Pro segue sem data.
DeepSeek lança oficialmente o V4-Pro e o Harness v0.1, ferramenta open-source de agentes que rivaliza com o Claude Code. API ganha preços por pico e fora de pico a partir de 16 de agosto.
Google DeepMind apresenta o Gemini 3.7 Flash, com preço introdutório 50% menor e avanços em codificação, automação e processamento de documentos.
OpenAI apresenta o modo Ultrafast para GPT-5.6 Sol, com até 14x mais velocidade e 750 tokens por segundo, usando infraestrutura da Cerebras.