CORA-Diff acelera modelos de linguagem de difusão sem retreino

CORA-Diff acelera modelos de linguagem de difusão sem retreino

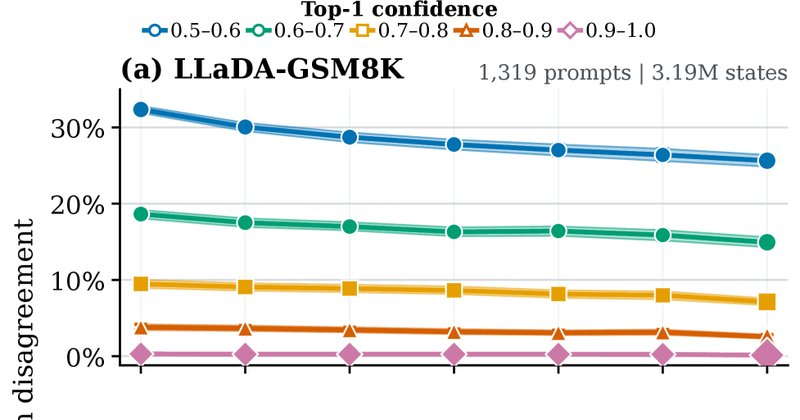
Artigo submetido ao arXiv propõe o CORA-Diff, método sem treinamento que corta passos redundantes de denoising e reduz o tempo de inferência em DLMs — com até 13,14x de speedup em protocolos específicos e queda máxima de 1,22 ponto nas tarefas.

Por Redação Mapa Paper13 ago
LinearKV: um único estado em cache basta para LLMs híbridos

LinearKV: um único estado em cache basta para LLMs híbridos

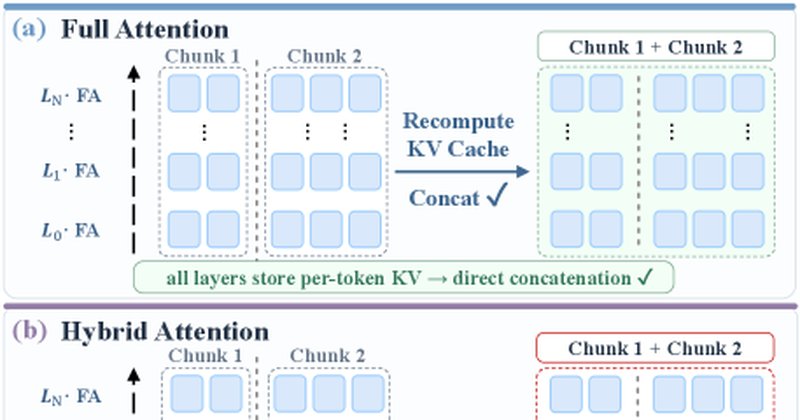
Paper no arXiv propõe o LinearKV, framework sem treinamento que adapta position-independent caching a LLMs híbridos. Um único estado em cache por camada linear recupera até 92% da qualidade, com menor latência que a composição exata de estados.

Por Redação Mapa Paper13 ago
Modelo matemático acelera em 17x a divisão de redes viárias

Modelo matemático acelera em 17x a divisão de redes viárias

Estudo submetido ao arXiv propõe novas formulações para particionar redes viárias em territórios contíguos, com aceleração de até 17x e solução ótima na maioria dos casos de distritização com equilíbrio de carga.

Por Redação Mapa Paper13 ago
Pesquisa propõe humano como professor ativo no treinamento de IA

Pesquisa propõe humano como professor ativo no treinamento de IA

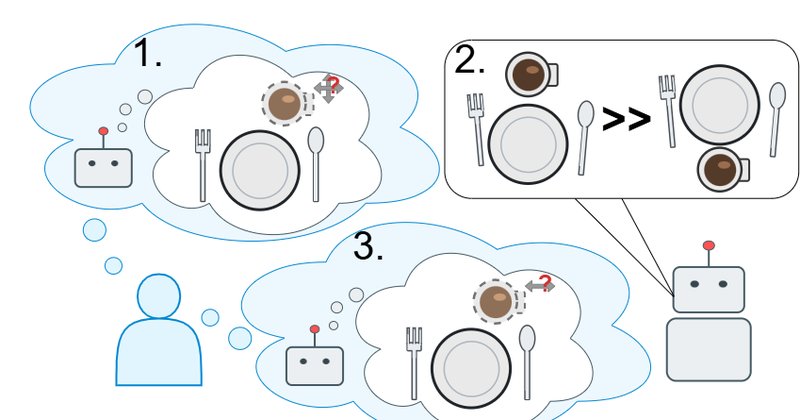
Estudo no arXiv inverte a lógica do aprendizado de IA por preferências: em vez de responder o algoritmo, o professor desenha o currículo e o aprendiz devolve declarações de entendimento. Em simulação, o método supera a seleção liderada pelo algoritmo e repara a deriva causada por troca de professores.

Por Redação Mapa Paper13 ago
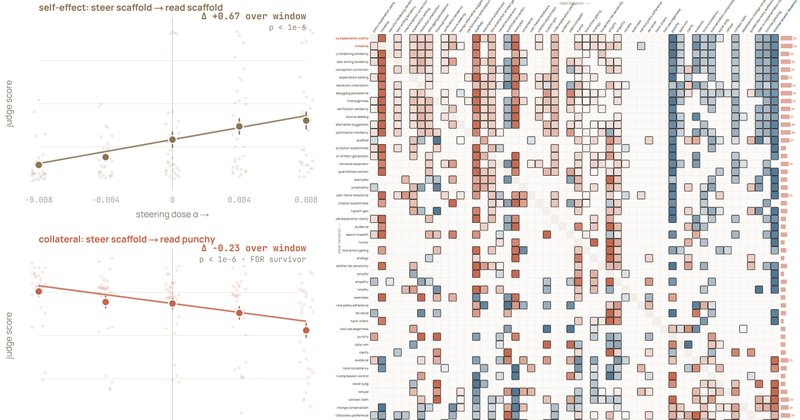
Previsão de efeitos colaterais em activation steering é possível

Previsão de efeitos colaterais em activation steering é possível

Pesquisadores mostram que os efeitos colaterais do activation steering podem ser previstos antes da aplicação da técnica, a partir das próprias representações do modelo. O estudo mapeou 67 comportamentos em três modelos open-weight.

Por Redação Mapa Paper13 ago