Skan AI levanta US$ 63 milhões para mapear como funcionários trabalham
Skan AI levanta US$ 63 milhões em Série C para mapear como funcionários trabalham e criar a base de dados que falta para agentes de IA saírem do papel nas empresas.
Skan AI levanta US$ 63 milhões em Série C para mapear como funcionários trabalham e criar a base de dados que falta para agentes de IA saírem do papel nas empresas.
Dois terços das empresas já rodam IA em produção, mas menos da metade consegue rastrear o custo do compute — e a maioria das GPUs opera com metade da capacidade ou menos.
Pesquisa com 107 empresas mostra que orquestração de agentes de IA virou ecossistema plural, com média de 3,1 plataformas por organização — e 20% não têm controle de custos em tempo real.
68% das empresas tiveram agentes de IA respondendo errado por causa de contexto de negócios ausente ou inconsistente; falha é recorrente em 37% delas, aponta pesquisa da VentureBeat.
A confiança na avaliação automatizada de agentes de IA quase triplicou entre junho e julho, mas a taxa de falhas em produção não mudou: 49% das empresas relatam agentes que passaram na avaliação e causaram falha para clientes.
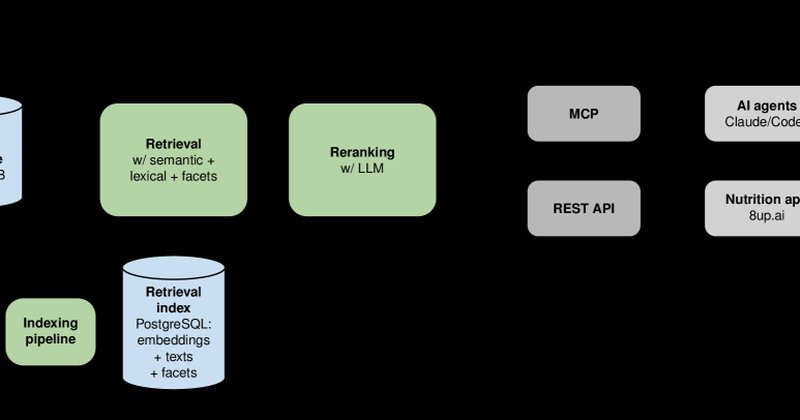
Preprint submetido ao arXiv propõe o Nutrition Data Service, infraestrutura que aplica princípios FAIR a dados de nutrição para tornar análises de agentes de IA reprodutíveis e auditáveis. Em testes no benchmark NutriBench, o serviço superou o melhor resultado publicado de modelos de linguagem.
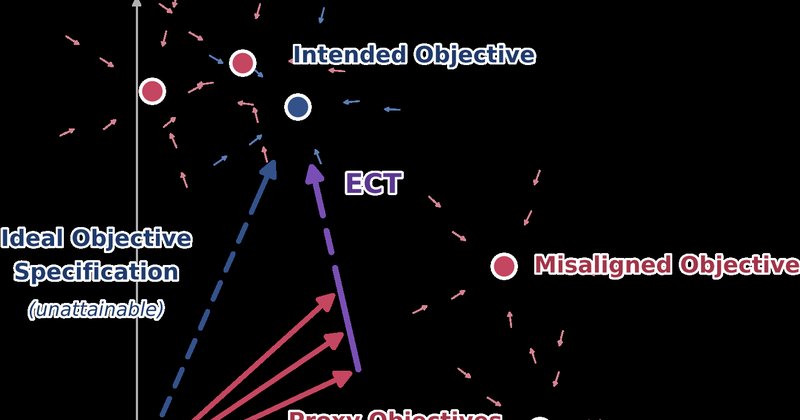
Um framework de pós-treinamento apresentado na arXiv ensina LLMs a compensar feedback imperfeito; em testes, reduziu sycophancy e melhorou a imparcialidade na geração de notícias.
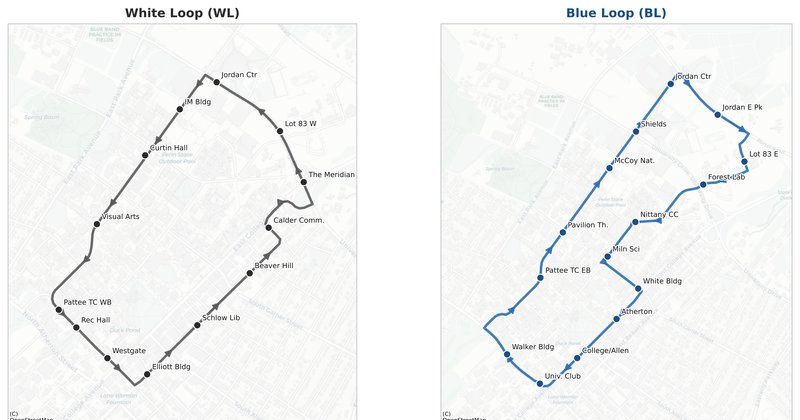
Estudo no arXiv mostra que embeddings semânticos de paradas, gerados offline por um LLM, reduzem em 69,2% os eventos de bunching e em 24,0% o tempo de espera em controladores de ônibus baseados em aprendizado por reforço.
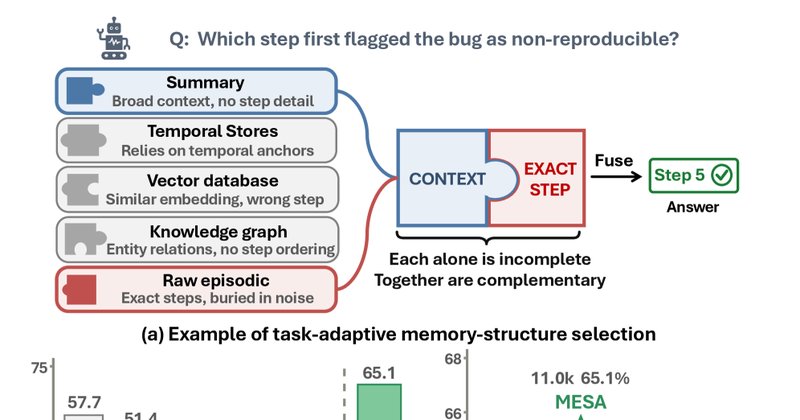
Pesquisadores propõem o MESA, framework que seleciona dinamicamente as memórias relevantes em agentes de IA de longo horizonte. No benchmark AMA-Bench, o método ganhou 8,5% em precisão e reduziu em 41% o uso de tokens.
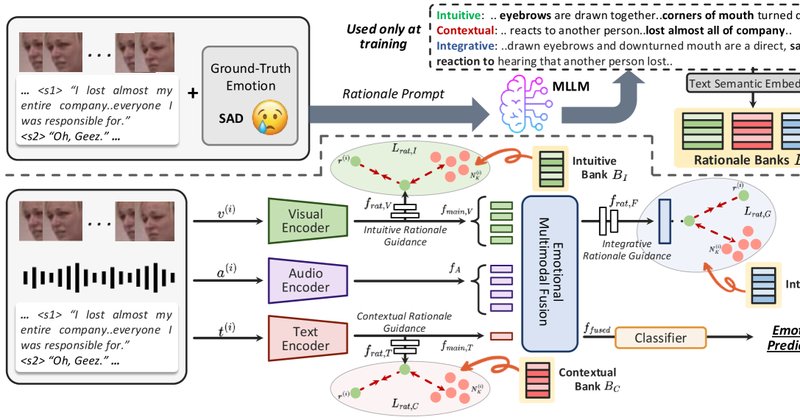
Pesquisadores propõem o framework RGL, que ensina modelos a reconhecer emoções em conversas com raciocínio humano, atingindo desempenho de ponta nos benchmarks IEMOCAP e MELD sem custo extra na inferência.