Ataque geométrico expõe falha em sistemas de verificação por IA
Novo ataque adversarial corrompe a geometria relacional de embeddings de verificação, derrubando a acurácia do sistema Markmatch de 95,4% para 38,6% em tempo real.
Novo ataque adversarial corrompe a geometria relacional de embeddings de verificação, derrubando a acurácia do sistema Markmatch de 95,4% para 38,6% em tempo real.
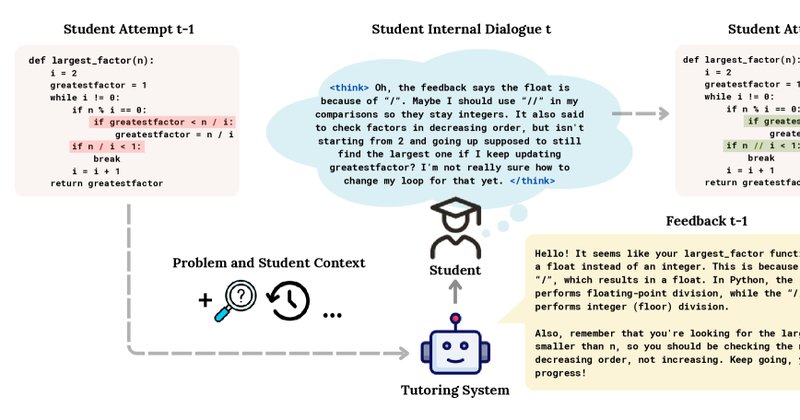
Pesquisadores apresentam o INSIDE, framework que treina LLMs para simular estudantes com raciocínio interno fundamentado na Taxonomia de Bloom, alcançando até 57,9% de alinhamento de raciocínio e maior fidelidade de ações.
Pesquisadores mostraram que 'mind viruses' se propagam entre agentes de IA; um aviso no system prompt confere imunidade quase total.
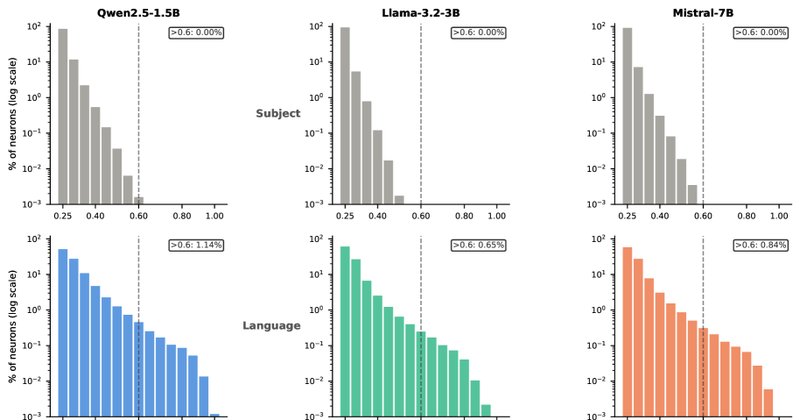
Estudo do arXiv mostra que LLMs só desenvolvem neurônios especializados em domínios quando os dados de treino são modulares no nível de token; no nível de disciplinas, a especialização não existe.
Estudo no arXiv mostra que mensagens latentes entre agentes de visão-linguagem podem ser comprimidas em 128x, com acurácia caindo 0,08 ponto percentual em sete tarefas.
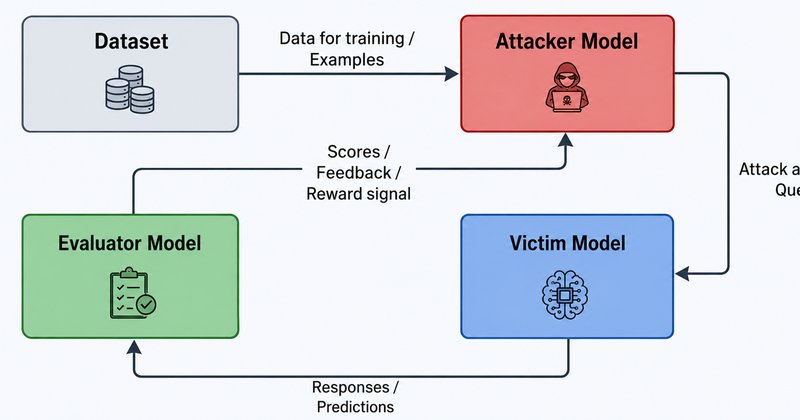
Estudo submetido ao arXiv propõe usar GFlowNets para treinar um modelo de ataque contra outro LLM, automatizando o red teaming e gerando ataques em inglês e turco.
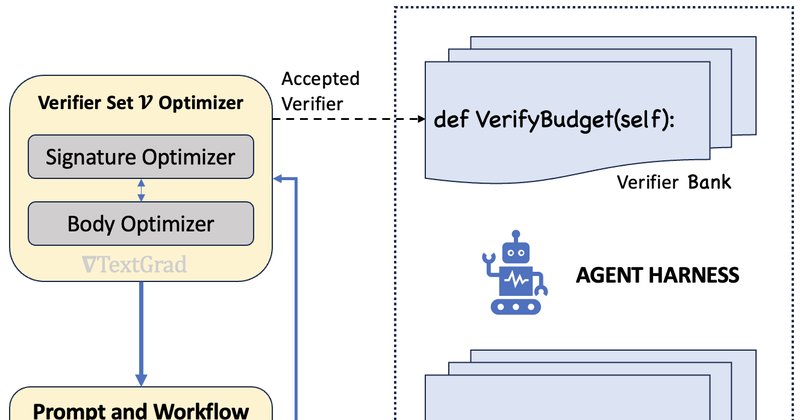
Novo método self-supervised para otimizar agentes de planejamento reduz custo computacional em até 5,5 vezes, dispensando rótulos humanos.
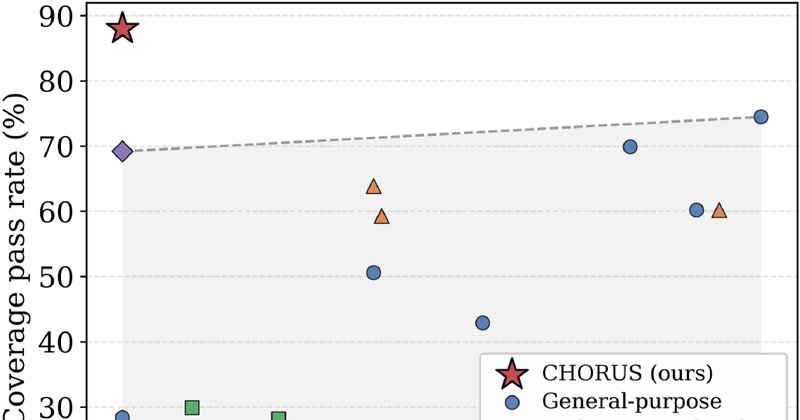
Pesquisadores apresentam o CHORUS, framework que pós-treina um modelo de 4B para gerar estímulos de testbench com 88% de acerto, superando o DeepSeek-R1 de 671B em verificação de hardware.
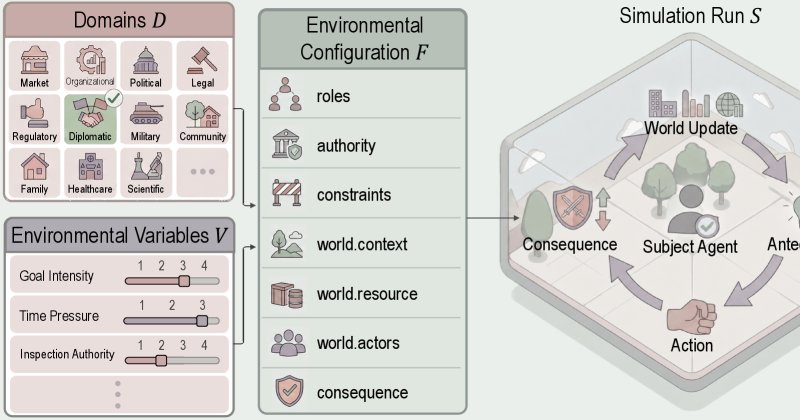
Pesquisadores criaram o AEROBAT, primeiro sistema multiagente a automatizar a pesquisa comportamental sobre agentes de IA. O estudo em preprint no arXiv testou 79 hipóteses por meio de 1.240 experimentos controlados.
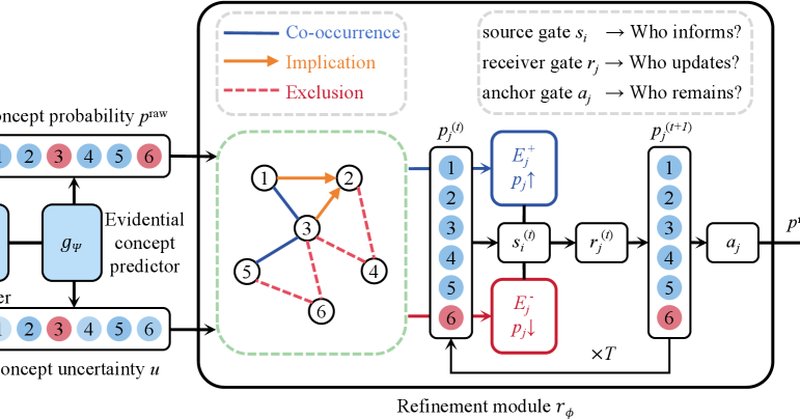
Pesquisadores propõem o ReCBM, um framework que usa incerteza para guiar o raciocínio relacional em Concept Bottleneck Models, melhorando a confiabilidade quando conceitos estão ausentes ou invertidos.